Transformer是目前最流行的深度学习架构之一,广泛应用于大语言模型(LLM)和计算机视觉等领域。
它的核心创新在于引入了自注意力机制(Self-Attention),使得模型能够更好地捕捉输入数据中的长距离依赖关系。
可视化Transformer
扩展链接-可视化Transformer
Transformer是目前最流行的深度学习架构之一,广泛应用于大语言模型(LLM)和计算机视觉等领域。
它的核心创新在于引入了自注意力机制(Self-Attention),使得模型能够更好地捕捉输入数据中的长距离依赖关系。
可视化Transformer
扩展链接-可视化Transformer
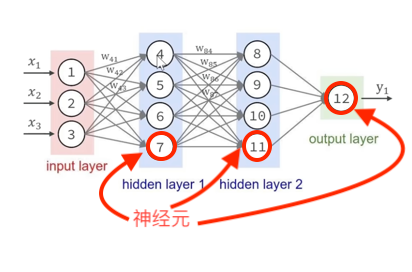
神经网络就是模仿人脑神经元的结构,其典型应用就是Transformer架构。
神经网络由输入层、隐藏层和输出层组成。
每一层由多个神经元组成,神经元之间通过权重连接。
输入层接收外部数据,隐藏层进行特征提取和变换,输出层产生最终结果。
有一段时间没有更新了,主要是去实习了,再加上这学期学校课比较多,导致没有时间更新😩
先讲一下这几个月,AI Coding工具的使用心得吧。
目前主流的AI Coding工具,国外的Codex 和 Claude Code,国内 Qoder 和 TRAE
在工具选择上,我的建议是,用的什么模型就选择对应Coding工具是最好的
JVM由 方法区(元空间)、堆、虚拟机栈、本地方法栈、程序计数器 组成
动态规划
对于每一间房屋,我们有两个选择:偷或者不偷。
首先记录每个字符最后出现的位置,然后从左到右遍历字符串,维护一个当前片段的结束位置,
当遍历到当前位置时,如果当前位置等于当前片段的结束位置,则将当前片段加入结果中,并更新下一个片段的开始位置。
杨辉三角的每一行都是由上一行生成的。具体来说,第n行的第i个元素等于上一行的第i-1个元素与第i个元素之和。因此,我们可以使用动态规划来解决这个问题。
dp公式:dp[i][j] = dp[i-1][j-1] + dp[i-1][j]
这是一个经典的动态规划问题。我们可以用 dp(n) 表示爬到第 n 个台阶的方法数。
因为每次可以爬 1 或 2 个台阶,所以 dp(n) = dp(n-1) + dp(n-2)。初始条件是 dp(1) = 1,dp(2) = 2。
本题可以使用贪心算法来解决。
我们维护两个变量:end 表示当前能够到达的最远位置,maxPos 表示在当前范围内能够到达的最远位置。
遍历数组,更新 maxPos,当遍历到 end 时,说明需要进行一次跳跃,更新 end 为 maxPos,并增加跳跃次数。
贪心算法
nums,你最初位于数组的第一个位置。数组中的每个元素代表你在该位置可以跳跃的最大长度。判断你是否能够到达最后一个位置。mx,表示当前能够跳跃到的最远位置。我们从数组的第一个位置开始,逐步更新 mx 的值。i,我们首先检查是否能够到达该位置,即 i 是否小于或等于 mx。如果不能到达该位置,说明我们无法继续前进,直接返回 false。mx 的值,取当前的 mx 和 i + nums[i] 的最大值。这样,我们就能够知道在当前位置能够跳跃到的最远位置。mx 的值大于或等于数组的最后一个位置,说明我们能够到达最后一个位置,返回 true。否则,返回 false。